Mokėjimų sukčiavimo aptikimas sumažėjo naudojant naujesnį AI atliekant Coinbase testą
Spalio 7 d. „Coinbase“ pranešė, kad naujesnės trijų pagrindinių dirbtinio intelekto modelių šeimų versijos užfiksavo mažiau apgaulingų mokėjimų ir mažesnę sukčiavimo vertės dalį atlikus istorinį „Onramp“ paslaugos mokėjimo patikrinimo testą, nepaisant nepakitusios sprendimų politikos. Išvados ginčija prielaidą, kad modelio atnaujinimas pagerina esamą mokėjimo tikrinimo priemonę.
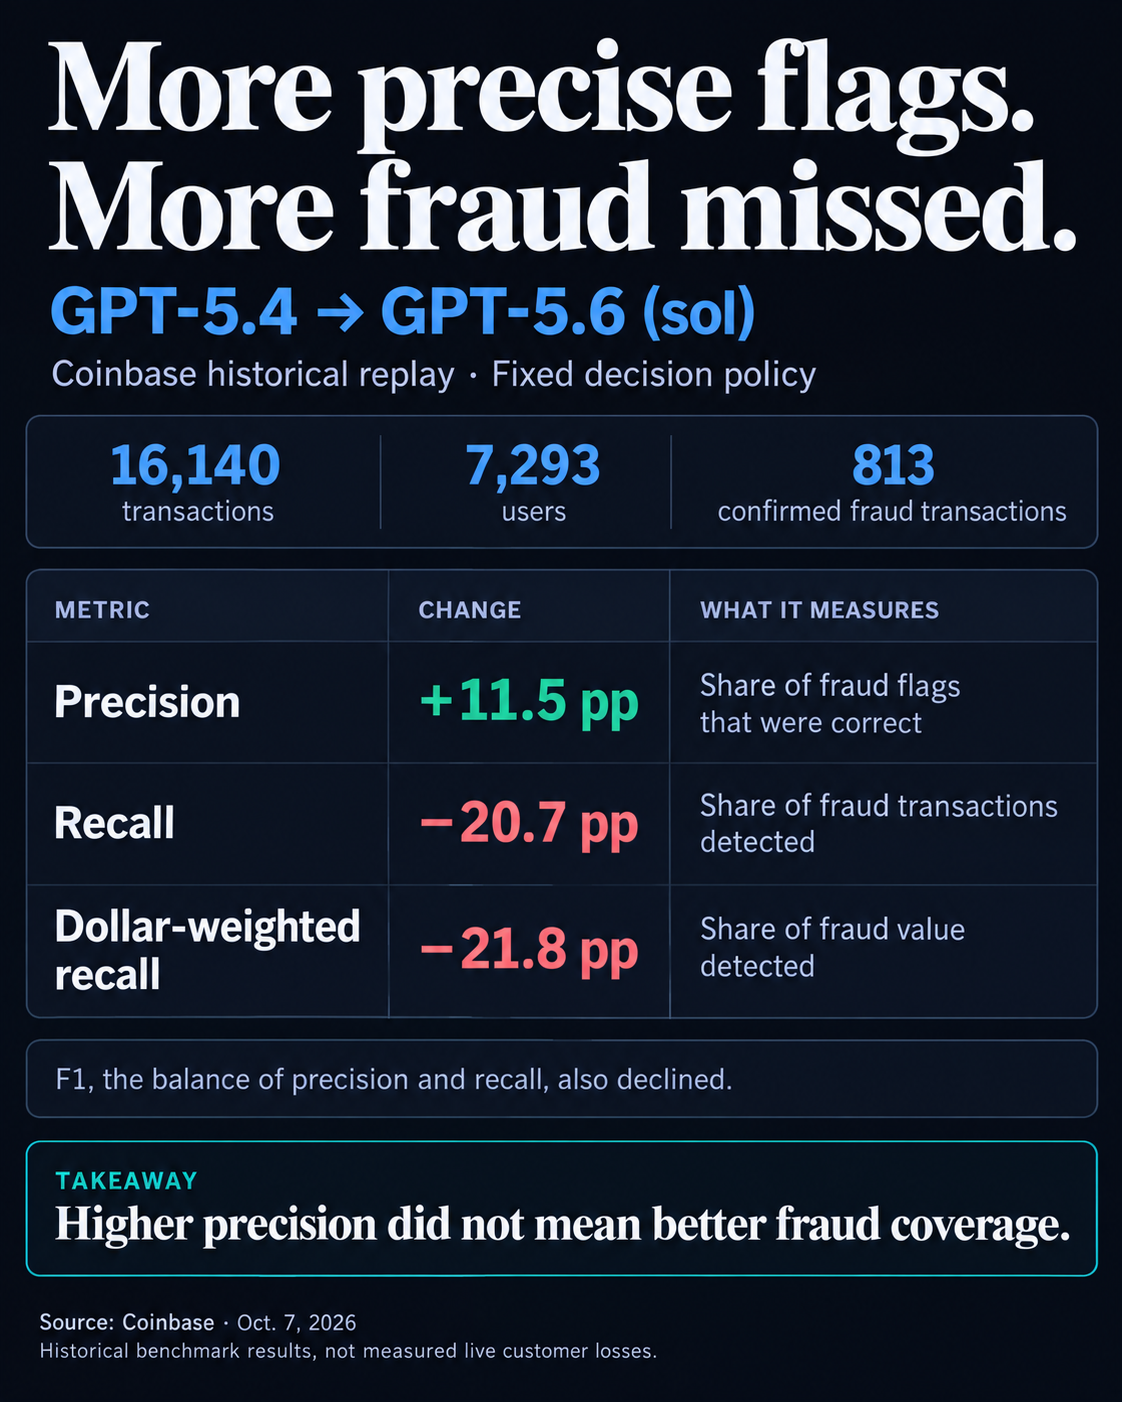
Bendrovės vertinimas atkartojo 16 140 operacijų iš 7 293 vartotojų, įskaitant 813 patvirtintų nesąžiningų sandorių. Grupė apėmė devynias savaites, kol jos rizikos agentas pasirodė, ir išlaikė visus subrendusius sukčiavimo atvejus, o atrinko teisėtą srautą.
Kiekvienas kandidatas peržiūrėjo pastarojo meto sandorių elgseną, vadovaudamasis nustatytomis gairėmis ir ta pačia politika, kaip rizikos klasifikaciją paversti sprendimais. Tai išskyrė sprendimo modelio elgesį toje sąrankoje, o ne palygino pertvarkytas atrankos sistemas.
Rezultatai iš fiksuoto istorinio pakartojimo
Coinbase palygino Opus 4.5 su Opus 5, Sonnet 4.6 su Sonnet 5 ir GPT-5.4 su GPT-5.6 (sol). Kiekviena naujesnė versija turėjo mažesnį atšaukimą, mažesnį kombinuotą tikslumo ir atšaukimo balą, vadinamą F1, ir mažesnį atšaukimą pagal dolerį. Prisiminimas matuoja sukčiavimo atvejų, kuriuos sugauna modelis, dalį; doleriais svertinis atšaukimas matuoja, kiek visos sukčiavimo vertės jis pagauna.
„Sonnet“ atšaukimas sumažėjo 22,2 procentinio punkto, o pagal doleris – 22,9 punkto. „Opus“ atšaukimas sumažėjo 0,8 punkto. Abu naujesni modeliai taip pat turėjo mažesnį tikslumą, o tai reiškia, kad mažesnė dalis sandorių, kuriuos jie priskyrė sukčiavimui, iš tikrųjų buvo apgaulingi.
GPT parodė, kodėl vienas geresnis balas gali būti klaidinantis. Jo tikslumas padidėjo 11,5 procentinio punkto, tačiau atšaukimas sumažėjo 20,7 punkto, o atšaukimas pagal dolerį sumažėjo 21,8 punkto. Jo sukčiavimo vėliavėlės buvo tikslesnės, o daugiau sukčiavimo atvejų ir vertės nebuvo aptikta pakartojant.
Pakartojimas nenustato klientų nuostolių diegiant šias versijas. Coinbase taip pat teigė, kad gali nustatyti regresijas nenustačius jų priežasties.
Ankstesnis „Coinbase“ internetinis eksperimentas palygino atrankinės LLM peržiūros pridėjimą tik su esamais modeliais ir taisyklėmis. Šis agento įgalintas srautas užfiksavo 30 % mažiau apgaulingų operacijų ir 22 % mažiau apgaulės vertės; ji nelygino naujesnių modelių versijų.
Dėl savo apribojimų SR-Fraud tyrėjai teigia, kad patentuoto duomenų rinkinio negalima išleisti, o tai riboja nepriklausomą replikaciją ir apibendrinimą. Su jais susijęs mokėjimų sukčiavimo tyrimas pirmą kartą pasirodė rugsėjo 23 d. ir buvo peržiūrėtas rugsėjo 30 d., prieš spalio mėnesio tinklaraščius.
Atskiras dėklas individualiam modeliui
Spalio 8 d. paskelbtame pranešime „Coinbase“ pranešė, kad vėliau apmokytas Qwen3.5-9B modelis viršijo Opus 4.5 pagal keturis sukčiavimo aptikimo rodiklius. F1 pagerėjo 9,6 procentinio punkto, o atsiėmimas pagal dolerį padidėjo 35,4 punkto. Bendrovė specializavosi naudodama istorinius sukčiavimo rezultatus ir deterministinius atlygius, subalansavusius nesąžiningus ir teisėtus pavyzdžius.
Atskirai, gamybos matavimai parodė, kad vidutinė LLM užklausos delsa yra 0,683 sekundės, palyginti su 1,515 sekundės Opus 4.5, tai yra 55 % santykinis sumažėjimas. Greitesnės išvados ir stipresnis etalono aptikimas buvo gauti iš skirtingų vertinimų.
Mokėjimo paslaugų teikėjams naujovinimo klausimas yra tas, ar kandidatas pagerina sukčiavimo aprėptį pagal savo faktinę sprendimų sąranką. Coinbase rekomenduoja pirmiausia išbandyti tą konfigūraciją, tada atskirai įvertinti pakeistus raginimus ar slenksčius, atsižvelgiant į delsą, patikimumą ir kainą kartu su aptikimo kokybe.